Мониторинг сайта не гарантирует, что сайт никогда не упадёт. Его задача — регулярно проверять доступность и состояние сайта, фиксировать проблемы и вовремя сообщать о них ответственным.
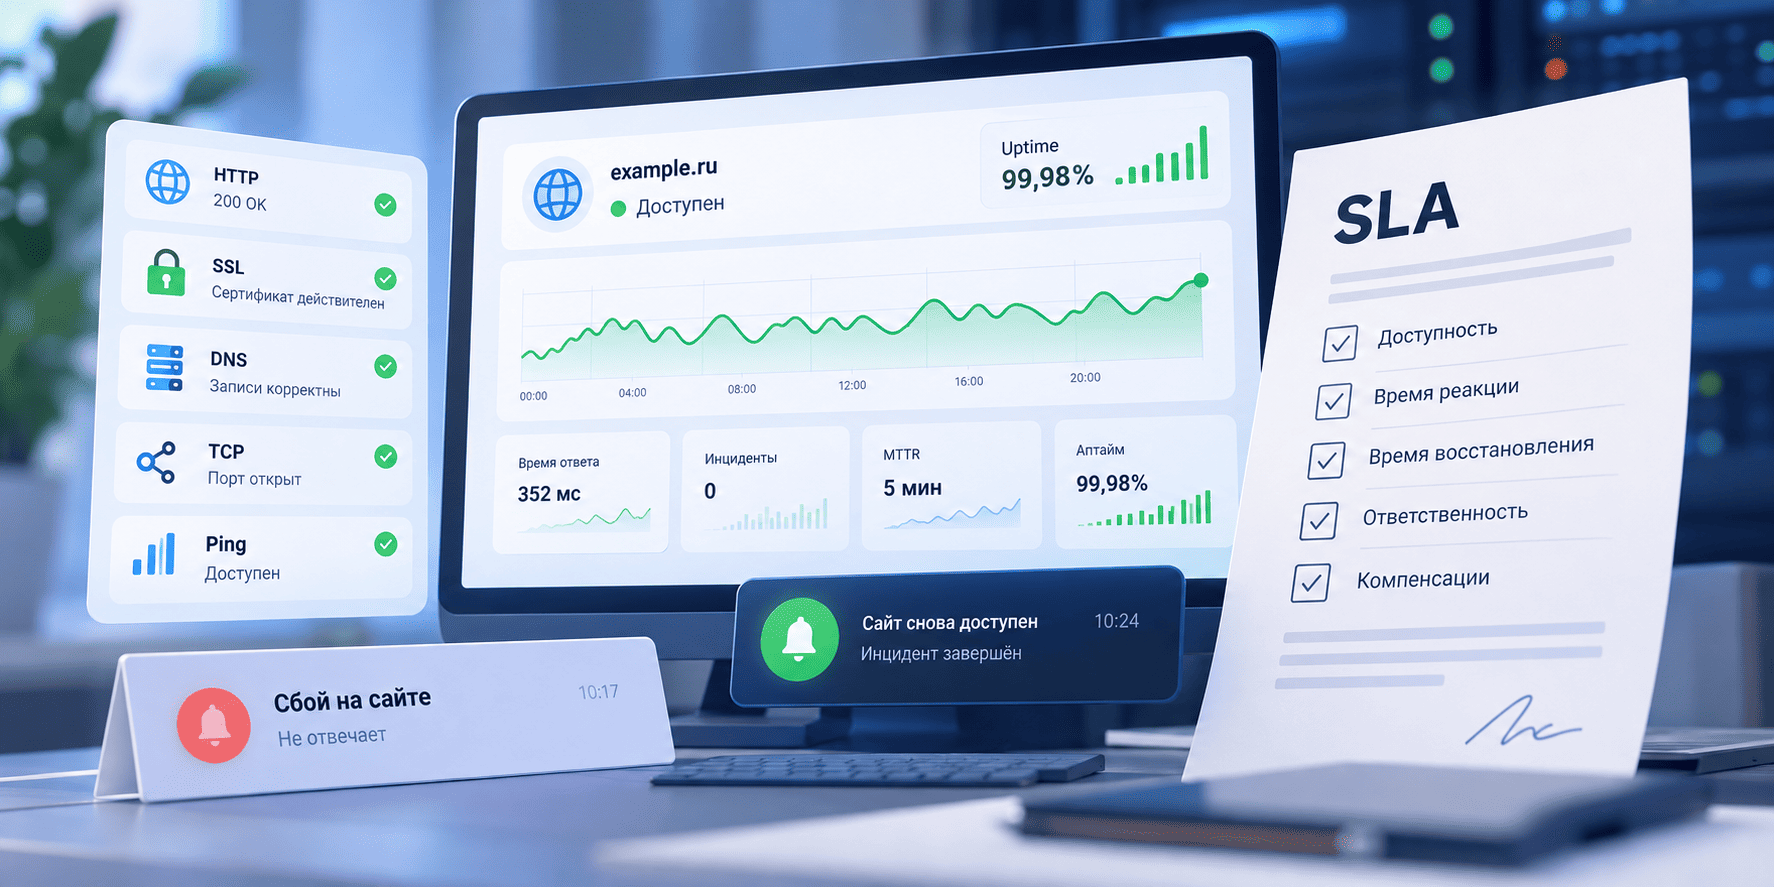
Гарантии доступности обычно определяются SLA (Service Level Agreement) — соглашением об уровне услуг между заказчиком и поставщиком. Мониторинг помогает проверить, выполняются ли эти обязательства, и предоставляет историю фактических инцидентов.
Разберём, чем мониторинг отличается от SLA, какие метрики действительно важны, как интервал проверки влияет на скорость обнаружения сбоя и как использовать мониторинг для контроля доступности сайта.
Что такое SLA и что оно гарантирует
SLA простыми словами
SLA (Service Level Agreement) — соглашение между заказчиком и поставщиком услуги, в котором определяются требования к её качеству и доступности.
Например, в SLA могут быть указаны:
- целевой уровень доступности;
- допустимое время простоя;
- время реакции на инцидент;
- время восстановления;
- порядок обращения в поддержку;
- условия компенсации при нарушении обязательств;
- исключения, которые не считаются нарушением SLA.
Главное: SLA — это договорённость между сторонами, а не функция системы мониторинга.
Сам по себе мониторинг не создаёт никаких гарантий. Он позволяет измерить, что происходило с сайтом или инфраструктурой.
Что обычно фиксируют в SLA
Чем конкретнее условия SLA, тем проще проверить их выполнение.
Например, вместо формулировки:
«Сервис должен работать стабильно».
можно установить:
«Доступность сервиса должна составлять не менее 99,9% за расчётный период».
И дополнительно определить:
- как рассчитывается доступность;
- откуда выполняются проверки;
- какие ошибки считаются недоступностью;
- учитываются ли плановые работы;
- какое время реакции считается допустимым;
- какая компенсация предусмотрена при нарушении.
Поэтому при работе с SLA важно не только наличие определённого процента uptime, но и понимать методику его расчёта.
Почему скорость работы сайта сложно использовать как единый показатель SLA
Скорость, которую получает пользователь, зависит от большого количества факторов:
- географии;
- интернет-провайдера;
- маршрутизации;
- CDN;
- устройства;
- браузера;
- размера страницы;
- сторонних сервисов.
Поэтому условие вроде «страница должна открываться не более чем за 2 секунды у любого пользователя» сложно использовать как универсальный показатель SLA.
При этом время ответа сервера из определённой точки мониторинга вполне можно измерять.
Например, можно контролировать:
- время установления соединения;
- время ответа HTTP-сервера;
- время выполнения запроса;
- задержку TCP-соединения;
- время ответа DNS.
Такие показатели уже можно использовать для технического контроля.
SLA определяет требования, а мониторинг показывает, насколько они выполняются.
Может ли сервис мониторинга гарантировать доступность сайта
Короткий ответ — нет.
Сервис мониторинга находится вне инфраструктуры сайта и наблюдает за ней. Он не может самостоятельно устранить проблему с сервером, исправить ошибку в коде или восстановить базу данных.
Если сервер перестал отвечать, мониторинг обнаружит это и отправит уведомление. Но исправлять причину сбоя должен тот, кто отвечает за соответствующую часть инфраструктуры.
Например:
- хостинг — за доступность предоставляемой инфраструктуры;
- облачный провайдер — за соответствующие компоненты облачной инфраструктуры;
- веб-студия или подрядчик — за те работы и компоненты, ответственность за которые предусмотрена договором;
- владелец сайта — за организацию эксплуатации и взаимодействие с подрядчиками.
Конкретная ответственность всегда определяется договором.
Что реально делает мониторинг
Современный мониторинг может контролировать не только факт открытия сайта.
С его помощью можно:
- проверять HTTP/HTTPS-доступность;
- контролировать HTTP-коды ответа;
- измерять время ответа;
- проверять содержимое страницы;
- контролировать SSL-сертификат и срок его действия;
- проверять DNS-записи;
- проверять TCP-порты;
- измерять сетевую задержку и потерю пакетов;
- контролировать срок регистрации домена;
- проверять отдельные SEO-параметры;
- искать заданные ключевые слова;
- фиксировать начало и окончание инцидента;
- хранить историю доступности;
- отправлять уведомления ответственным;
- рассчитывать статистику за выбранный период.
Например, сайт может формально открываться, но при этом сервер начинает отвечать в несколько раз медленнее обычного. HTTP-мониторинг позволит увидеть изменение времени ответа ещё до полного отказа сайта.
Что мониторинг не делает
Мониторинг сам по себе:
- не предотвращает сбои;
- не исправляет ошибки приложения;
- не восстанавливает сервер;
- не заменяет резервное копирование;
- не заменяет SLA;
- не компенсирует финансовые потери от простоя.
Его задача — дать объективную информацию о состоянии системы и как можно быстрее сообщить о проблеме.
Мониторинг не делает сайт неуязвимым. Он уменьшает время между возникновением проблемы и моментом, когда о ней узнают.
Мониторинг и SLA — в чём разница
| Критерий | Мониторинг | SLA |
|---|---|---|
| Что это | Инструмент наблюдения | Договор об уровне услуг |
| Основная задача | Измерять состояние системы | Зафиксировать обязательства сторон |
| Что показывает | Фактические результаты проверок | Требуемый уровень качества |
| Кто устанавливает | Владелец или техническая команда | Заказчик и поставщик |
| Содержит санкции | Обычно нет | Может содержать |
| Может гарантировать доступность | Нет | Определяет договорный уровень услуги |
| Помогает доказать нарушение | Да | Определяет, что считать нарушением |
Эти инструменты не конкурируют друг с другом.
SLA определяет, что должно быть.
Мониторинг показывает, что произошло на самом деле.
Если у хостинга заявлена доступность 99,9%, внешний мониторинг может предоставить независимую статистику, с которой можно сравнить фактическое состояние сайта с договорными условиями.
Какие метрики действительно важны
Одного показателя uptime недостаточно, чтобы полностью оценить надёжность сайта.
Uptime
Uptime — доля времени, когда сервис был доступен в течение выбранного периода.
Например, если за месяц сервис был недоступен некоторое время, итоговый процент доступности покажет, насколько это повлияло на общий показатель.
Но высокий uptime не обязательно означает хорошее качество работы.
Сайт может быть доступен большую часть времени, но:
- медленно отвечать;
- периодически отдавать ошибки;
- иметь проблемы с DNS;
- терять соединения;
- неправильно работать на отдельных страницах.
Поэтому uptime лучше рассматривать вместе с другими показателями.
MTTR
MTTR (Mean Time To Repair/Recovery) — среднее время восстановления после инцидента.
Чем меньше MTTR, тем быстрее команда возвращает сервис в рабочее состояние после сбоя.
Для владельца сайта это особенно важная метрика: два сайта могут иметь одинаковое количество инцидентов, но один восстанавливается за несколько минут, а другой — за несколько часов.
MTBF
MTBF (Mean Time Between Failures) — среднее время работы между последовательными отказами.
Эта метрика помогает оценить частоту возникновения проблем.
Если MTBF уменьшается, это может говорить о том, что сбои стали происходить чаще.
P95 времени ответа
P95 — значение, ниже которого находится 95% измерений за выбранный период.
Например, если P95 времени ответа равен 1,2 секунды, это означает, что 95% измерений были не хуже этого значения, а примерно 5% оказались медленнее.
P95 полезен тем, что среднее значение может скрывать отдельные серьёзные задержки.
Почему одного uptime недостаточно
Представим интернет-магазин.
За месяц он показывает 99,9% доступности. На первый взгляд показатель выглядит хорошо.
Но при этом несколько раз в день время ответа сервера увеличивается с 500 мс до 5–10 секунд. Иногда сервер возвращает ошибку 502, а часть запросов к API завершается с ошибкой.
Формально сайт почти всё время доступен.
Но для бизнеса ситуация уже плохая: пользователи ждут загрузки страниц, не могут оформить заказ или уходят с сайта.
Поэтому мониторинг нужен не только для обнаружения полного падения сайта.
Изменение времени ответа и появление отдельных ошибок тоже могут быть сигналами ухудшения работы.
Как интервал проверки влияет на обнаружение сбоя
Это один из самых важных параметров любого мониторинга.
Если проверки выполняются раз в 5 минут, сайт может перестать работать сразу после очередной проверки. В таком случае мониторинг обнаружит проблему только во время следующей проверки.
При интервале 30 секунд окно обнаружения значительно меньше.
Если предположить, что сбой может произойти в любой момент между двумя равномерными проверками, среднее время до обнаружения примерно равно половине интервала:
| Интервал проверки | Среднее время до обнаружения |
|---|---|
| 5 минут | около 2,5 минут |
| 1 минута | около 30 секунд |
| 30 секунд | около 15 секунд |
Это расчётное среднее значение при условии, что сбой может начаться в любой момент между двумя проверками.
Но интервал проверки — не единственный фактор.
После обнаружения проблемы ещё требуется:
- доставить уведомление;
- чтобы ответственный его увидел;
- определить причину;
- устранить проблему;
- проверить восстановление.
Поэтому сокращение интервала мониторинга уменьшает время обнаружения, но не гарантирует столь же быстрое восстановление.
Какой интервал проверки выбрать
Универсального значения нет.
Для небольшого информационного сайта проверка раз в несколько минут может быть вполне достаточной.
Для интернет-магазина, онлайн-сервиса или сайта, от которого напрямую зависит бизнес, более частые проверки позволяют быстрее обнаруживать проблемы.
При выборе интервала стоит учитывать:
- критичность сайта;
- допустимое время обнаружения;
- нагрузку от проверок;
- стоимость мониторинга;
- количество проверяемых ресурсов.
Важно понимать разницу между:
«сайт был недоступен 5 минут»
и
«мы узнали о недоступности через 5 минут».
Это не одно и то же.
Сайт мог быть недоступен уже несколько минут до того, как мониторинг обнаружил проблему.
Кто отвечает за простой сайта
Ответственность зависит от того, где возникла проблема и какие обязательства зафиксированы в договорах.
Хостинг или облачный провайдер
Может отвечать за доступность предоставляемой инфраструктуры в пределах своего SLA.
Веб-студия или подрядчик
Может отвечать за разработку и сопровождение сайта, если соответствующие обязательства предусмотрены договором.
Владелец сайта
Отвечает за организацию эксплуатации сайта, выбор подрядчиков и взаимодействие с поставщиками услуг.
Сервис мониторинга
Если для него предусмотрены договорные обязательства, они относятся к работе самого сервиса мониторинга, например к доступности его инфраструктуры и доставке уведомлений.
При этом мониторинг не становится ответственным за работу самого сайта только потому, что он его проверяет.
Что стоит зафиксировать в SLA
Если доступность сайта критична для бизнеса, лучше заранее определить не только процент uptime.
Полезно зафиксировать:
- целевой uptime;
- расчётный период;
- допустимую длительность одного инцидента;
- суммарное допустимое время простоя;
- время реакции;
- время восстановления;
- порядок эскалации;
- каналы связи;
- правила проведения плановых работ;
- исключения;
- условия компенсации.
Особенно важно заранее определить, как именно считается нарушение SLA.
Например, разные стороны могут по-разному понимать, считается ли кратковременный HTTP 500 ошибкой, учитываются ли плановые работы и из какой точки выполняются измерения.
Как выбрать сервис мониторинга
При выборе мониторинга стоит смотреть не только на цену и количество сайтов.
Интервал проверки
Чем критичнее сервис, тем важнее возможность настроить подходящую частоту проверок.
Типы проверок
Минимальный набор для сайта — HTTP и SSL.
В зависимости от инфраструктуры могут понадобиться:
- DNS;
- TCP;
- Ping;
- WHOIS;
- проверка содержимого;
- SEO-проверки.
Уведомления
Важно, чтобы сообщение о проблеме попадало к человеку, который действительно может её устранить.
Полезными могут быть:
- email;
- Telegram;
- webhook;
- правила уведомлений и эскалации.
История и аналитика
Без истории трудно понять, насколько часто возникают проблемы.
Полезно видеть:
- uptime;
- длительность инцидентов;
- время ответа;
- P95;
- MTTR;
- MTBF;
- почасовую и дневную статистику.
Диагностика
Хороший мониторинг должен помогать не только ответить на вопрос «сайт работает?», но и приблизиться к ответу на вопрос «почему он не работает?».
Например, последовательная проверка DNS → TCP → SSL → HTTP позволяет сузить область поиска проблемы.
Status Page
Если сервис или сайт регулярно сталкивается с инцидентами, публичная status page позволяет сообщать пользователям о состоянии системы и текущих проблемах.
API
REST API полезен для интеграции мониторинга с собственными системами, скриптами, внутренними панелями и процессами реагирования.
Что важно учитывать при выборе мониторинга в России
Для российских компаний отдельное значение имеют вопросы хранения и обработки данных.
При выборе сервиса стоит проверить:
- где размещается инфраструктура;
- где хранятся данные мониторинга;
- какие персональные данные обрабатываются;
- какие условия обработки данных предусмотрены;
- соответствует ли выбранная схема требованиям компании и применимому законодательству.
Для Пульсоры одним из принципов является размещение инфраструктуры и данных в РФ с учётом требований 152-ФЗ.
Как использовать мониторинг для контроля SLA
Практический подход можно свести к нескольким шагам.
1. Определить, что именно считается доступностью
Например:
HTTP-запрос к определённому URL должен возвращать успешный ответ.
2. Определить допустимые значения
Например:
- uptime не ниже установленного значения;
- время ответа не выше определённого порога;
- время реакции на инцидент — не более заданного значения.
3. Настроить независимый мониторинг
Проверки должны выполняться регулярно и сохранять историю результатов.
4. Настроить уведомления
Недостаточно просто обнаружить проблему. Ответственный должен узнать о ней достаточно быстро.
5. Анализировать историю
По итогам месяца или квартала можно сравнивать фактические показатели с условиями SLA.
Так мониторинг становится не просто системой оповещений, а инструментом контроля качества услуги.
Пульсора для контроля доступности сайта
Пульсора объединяет несколько типов проверок в одном сервисе: HTTP, SSL, DNS, TCP, Ping, WHOIS и SEO.
Можно отдельно контролировать доступность сайта, сертификат, DNS, сетевые соединения и другие параметры, а результаты сохраняются в истории мониторинга.
Сервис также позволяет настроить уведомления, создавать status pages и использовать API для интеграций.
В период раннего доступа основные возможности Пульсоры доступны бесплатно в рамках установленных квот.
Что делать владельцу сайта
Если мониторинг ещё не настроен, необязательно сразу контролировать всю инфраструктуру.
Для начала достаточно:
- Настроить HTTP-проверку сайта.
- Добавить контроль SSL.
- Проверить DNS.
- Настроить уведомления.
- Определить допустимое время обнаружения сбоя.
- Через некоторое время посмотреть историю инцидентов и время ответа.
- Если сайт критичен для бизнеса — дополнить мониторинг TCP, Ping, WHOIS и другими проверками.
А если с подрядчиком или хостингом заключён SLA, стоит заранее определить, какие показатели мониторинга будут использоваться для проверки его выполнения.
FAQ
Может ли мониторинг предотвратить падение сайта?
Нет. Мониторинг обнаруживает проблему и уведомляет ответственных. Предотвращение и устранение сбоев требуют других инструментов и процессов.
Гарантирует ли SLA, что сайт никогда не упадёт?
Нет. SLA определяет согласованный уровень услуги и последствия его нарушения. Даже SLA с очень высоким целевым uptime допускает определённое количество недоступности в рамках расчётного периода.
Зачем нужен мониторинг, если есть SLA?
Чтобы получать независимые измерения фактической доступности и времени ответа и иметь историю инцидентов.
Какой интервал мониторинга выбрать?
Он зависит от критичности сайта. Чем быстрее нужно узнать о проблеме, тем меньше должен быть интервал проверки.
Достаточно ли проверять только HTTP?
Для простого сайта это хороший первый шаг. Но HTTP-проверка не обнаружит все возможные проблемы. Например, отдельные проверки DNS, SSL и TCP помогают найти проблемы на других уровнях.
Что важнее — uptime или время ответа?
Они измеряют разные вещи. Uptime показывает доступность, а время ответа — насколько быстро система отвечает. Для полноценной оценки качества полезно смотреть на оба показателя.
Заключение
Мониторинг не гарантирует, что сайт не упадёт. Он позволяет вовремя узнать о проблеме и получить объективные данные о том, что происходило с сайтом.
SLA определяет, какой уровень услуги должен быть обеспечен.
Мониторинг показывает, какой уровень был фактически достигнут.
Поэтому эти инструменты лучше использовать вместе: зафиксировать требования в SLA, регулярно измерять их с помощью мониторинга и сохранять историю инцидентов.
Так разговор о надёжности сайта превращается из субъективного «кажется, он часто падает» в конкретные показатели: uptime, время ответа, количество инцидентов, MTTR и MTBF.
Если мониторинг сайта вам ещё не настроен, можно начать с базовых проверок HTTP, SSL и DNS, а затем добавить дополнительные проверки и уведомления по мере необходимости.
Пульсора позволяет собрать эти проверки в одном сервисе и начать мониторинг без сложной настройки. В период раннего доступа основные возможности доступны бесплатно в рамках установленных квот.